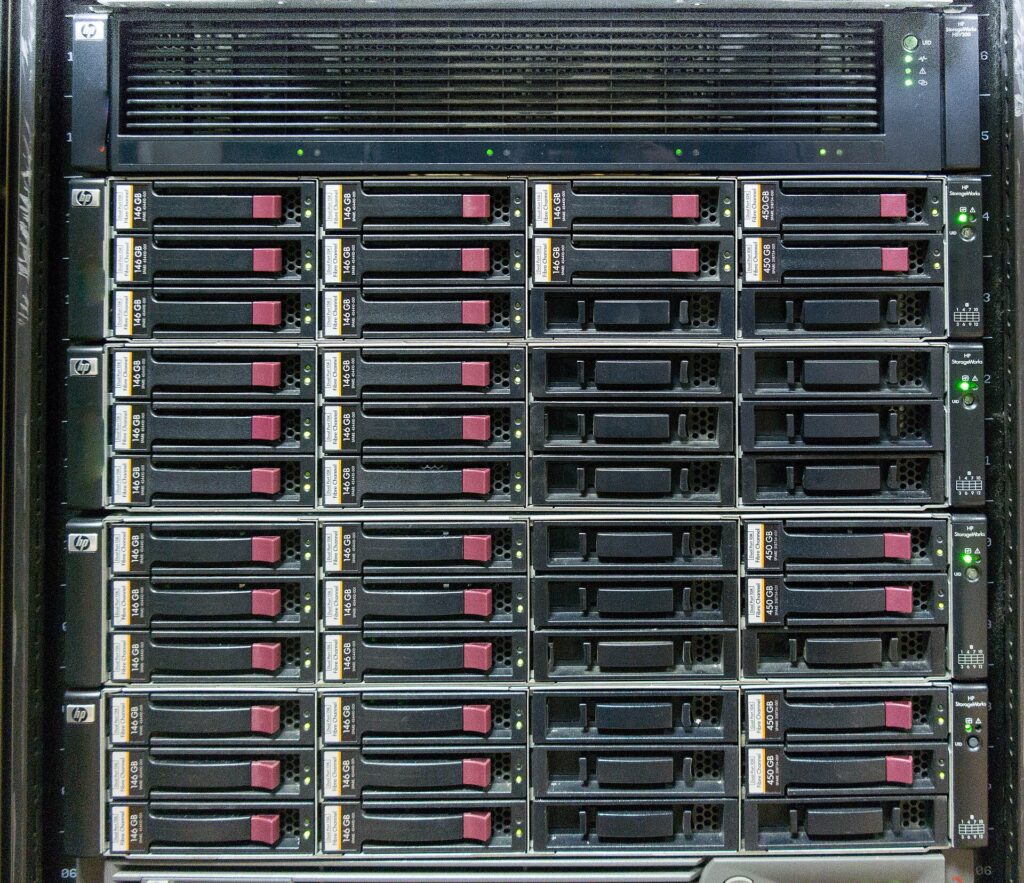
SAN과 NAS의 차이는 저장 장치가 크거나 비싼지보다 서버에 무엇을 제공하는지에서 시작합니다. 일반적인 SAN은 서버에 블록 장치를 제공하고, NAS는 네트워크로 파일을 읽고 쓰는 서비스를 제공합니다. 같은 SSD를 사용하고 같은 Ethernet 스위치를 지나더라도 서버가 데이터를 다루는 계층은 달라질 수 있어요.
스토리지를 처음 공부하는 분과 가상화 인프라를 설계하는 운영자를 위해 개념, 프로토콜, 성능, 이중화와 복구를 연결해 설명합니다. ‘SAN은 빠르고 NAS는 느리다’는 구분 대신, 업무의 접근 방식과 장애 조건에 맞춰 선택하는 기준을 다룹니다.
이 글의 목차
SAN과 NAS를 구분하는 첫 기준
SAN은 스토리지에 접근하는 네트워크입니다
SAN(Storage Area Network)은 서버와 스토리지를 연결하는 저장 장치용 네트워크입니다. 서버, 스위치, 스토리지 포트와 장치가 함께 구성하며, 일반적인 블록 스토리지 환경에서는 서버가 원격 저장 공간을 로컬 디스크와 비슷한 블록 장치로 인식합니다. SAN을 스토리지 본체 한 대만을 가리키는 말로 사용하면 네트워크 경로와 호스트 설정을 놓치기 쉽습니다. SNIA의 SAN 설명
블록은 데이터를 일정한 크기의 주소 단위로 읽고 쓰는 방식입니다. 서버는 제공받은 장치에 파일시스템을 만들거나, 데이터베이스·볼륨 관리자처럼 블록 장치를 직접 다루는 소프트웨어를 사용할 수 있습니다. 스토리지가 논리 공간을 제공하고, 서버 쪽에서 그 공간을 어떻게 사용할지 결정하는 구조로 이해하면 됩니다.
NAS는 파일 접근 서비스를 제공합니다
NAS(Network Attached Storage)는 네트워크로 파일 접근 서비스를 제공하는 저장 시스템입니다. 클라이언트는 NFS나 SMB 같은 프로토콜로 공유 경로에 접속하고, 파일 이름과 디렉터리를 기준으로 데이터를 읽고 씁니다. 파일시스템과 공유 서비스는 NAS 쪽이 관리합니다. SNIA의 NAS 정의
개인용 2베이 제품도 NAS이고, 여러 컨트롤러와 대규모 용량을 갖춘 기업용 파일 스토리지도 NAS입니다. NAS라는 이름만으로 성능, 이중화 수준, 최대 용량을 판단할 수 없습니다. NFS나 SMB로 서비스를 제공한다는 사실과 제품 등급을 나누어 봐야 합니다.
| 구분 | SAN을 이용하는 일반적인 블록 구성 | NAS 파일 서비스 |
|---|---|---|
| 서버에 보이는 대상 | LUN·네임스페이스 등의 블록 장치 | 공유 폴더·파일·디렉터리 |
| 파일시스템 관리 | 서버·하이퍼바이저·클러스터 소프트웨어 | NAS의 파일시스템과 파일 서비스 |
| 대표 프로토콜 | FC, iSCSI, NVMe/FC, NVMe/TCP | NFS, SMB |
| 주된 접근 제어 | 호스트 식별자, 매핑, 패브릭 정책 등 | 공유 권한, 파일 권한, 사용자 인증 등 |
두 방식은 한 장비 안에 함께 존재할 수 있습니다. 파일 공유와 블록 서비스를 모두 제공하는 통합 스토리지에서는 장비의 상표보다 실제로 연결한 프로토콜을 확인해야 해요. 다만 두 서비스를 제공한다고 같은 데이터를 양쪽 방식으로 동시에 안전하게 수정할 수 있다는 뜻은 아닙니다. 제품이 지원하는 데이터 접근 모델을 따라야 합니다.
서버에서 디스크까지, 데이터가 지나가는 경로
SAN의 기본 경로
FC 또는 iSCSI 환경에서는 서버 쪽 요청 주체를 initiator, 스토리지 쪽 제공 주체를 target이라고 부릅니다. 서버의 HBA나 NIC에서 요청이 나가고 스위치와 스토리지 포트를 거쳐 저장 공간에 접근합니다. LUN(Logical Unit Number)은 SCSI 논리 장치를 식별하는 번호이지만, 운영에서는 서버에 제공하는 논리 블록 장치를 ‘LUN’이라고 부르는 일이 많습니다.
스토리지는 호스트 식별자를 기준으로 어떤 장치를 보여 줄지 결정합니다. FC에서는 WWPN, iSCSI에서는 IQN 같은 식별자를 만날 수 있습니다. 케이블이 연결되어도 호스트 매핑이 맞지 않으면 서버에 장치가 보이지 않을 수 있어요. NetApp의 SAN 구성과 호스트 매핑 설명
| 단계 | 블록 접근에서의 역할 | 운영자가 확인할 지점 |
|---|---|---|
| 애플리케이션·파일시스템 | 데이터를 파일 또는 블록으로 사용 | 지연, 오류, 마운트와 장치 상태 |
| 호스트 스토리지 계층 | 장치 요청과 다중 경로 처리 | 드라이버, 경로, 타임아웃 |
| HBA·NIC와 스위치 | 스토리지 트래픽 전달 | 링크, 오류, 혼잡, 접근 범위 |
| 스토리지 포트·컨트롤러 | 장치 제공과 I/O 처리 | 호스트 매핑, 포트, 컨트롤러 부하 |
| 디스크·플래시·스토리지 풀 | 실제 데이터 보관 | 여유 공간, 매체 상태, 재구축 |
하이퍼바이저가 블록 스토리지를 받아 데이터스토어를 만들고, 그 안에 VM의 가상 디스크 파일을 저장할 수도 있습니다. 이 경우 게스트 OS가 보는 디스크와 실제 SAN 장치는 다른 계층입니다. 게스트의 디스크 지연을 조사할 때 하이퍼바이저와 물리 경로까지 이어서 봐야 하는 이유입니다.
NAS의 기본 경로
NAS에서는 클라이언트의 NFS·SMB 요청이 네트워크를 통해 파일 서비스에 도착합니다. NAS는 사용자 권한과 파일·디렉터리 정보를 확인한 뒤 내부 저장 공간에 접근합니다. 클라이언트는 보통 NAS 내부의 실제 디스크나 RAID 구성을 직접 관리하지 않습니다.
NAS 장애가 모두 디스크 장애는 아닙니다. 공유 이름, DNS, 인증 서버, 사용자 ID 매핑, 파일 권한과 네트워크 연결 중 어느 한 부분만 어긋나도 파일이 열리지 않을 수 있습니다. ‘서버에서 ping이 된다’는 결과만으로 파일 서비스가 정상이라고 판단하면 원인을 찾기 어렵습니다.
FC, iSCSI, NFS, SMB는 어떻게 다른가
Fibre Channel: 별도의 스토리지 패브릭
Fibre Channel(FC)은 기업용 SAN에서 사용하는 연결 기술입니다. 전용 HBA와 FC 스위치를 사용하는 구성이 일반적이며, 스토리지 트래픽을 업무용 Ethernet과 별도 패브릭으로 설계할 수 있습니다. 전용 경로를 두면 자원과 장애 범위를 관리하기 좋지만, 장비와 운영 기술에 드는 비용을 함께 고려해야 합니다.
FC라는 이름이 광케이블 자체를 뜻하지는 않습니다. 중요한 것은 전송 기술과 프로토콜, 지원되는 연결 구성입니다. SNIA도 FC 위에서 SCSI뿐 아니라 NVMe 등 여러 프로토콜을 전송할 수 있다고 설명합니다. SAN의 연결 기술과 프로토콜
iSCSI: IP 네트워크로 블록 장치를 연결합니다
iSCSI는 SCSI 명령을 TCP/IP로 전달하는 방식입니다. Ethernet NIC와 IP 네트워크를 활용해 블록 스토리지를 연결할 수 있습니다. 따라서 ‘랜선으로 연결하니 NAS’라고 구분하면 iSCSI를 잘못 이해하게 됩니다.
기존 Ethernet 기술을 활용할 수 있어도 운영용 스토리지 트래픽에는 대역폭, 경로 분리, 드라이버와 다중 경로 설계가 필요합니다. 관리 화면에 장치가 보인다는 사실과 안정적인 운영이 가능하다는 판단은 다릅니다. 호스트 OS와 스토리지 공급사의 지원 조합을 맞춰야 합니다. ONTAP의 SAN 지원 구성 확인
NVMe over Fabrics: NVMe 명령을 네트워크로 확장합니다
NVMe/FC와 NVMe/TCP는 NVMe 명령을 각각 FC와 TCP 기반 네트워크로 전달하는 방식입니다. 여기서 호스트에 제공되는 논리 저장 공간은 NVMe namespace라고 부릅니다. NVMe SSD가 들어 있는 장비라는 사실만으로 해당 장비가 NVMe/TCP 연결을 지원한다고 판단할 수는 없습니다.
매체가 NVMe인지, 내부 연결이 무엇인지, 호스트가 어떤 프로토콜로 접근하는지는 따로 확인합니다. OS, NIC·HBA, 드라이버, 펌웨어, 스토리지 모델과 소프트웨어 버전이 맞아야 합니다. 실제 지원 조합은 공급사 매트릭스를 기준으로 확인합니다. NetApp의 NVMe 구성·제약
NFS와 SMB: 파일을 공유하는 프로토콜
NFS는 Linux·Unix 계열 및 가상화 환경의 파일 스토리지에서 널리 사용됩니다. SMB는 Windows 파일 공유와 밀접하지만 Windows에서만 사용할 수 있는 프로토콜은 아닙니다. 어느 쪽이든 클라이언트와 서버가 지원하는 프로토콜 버전, 인증, 잠금, 암호화 기능을 확인해야 합니다.
NFS를 쓰는 환경에서는 사용자·그룹 ID, export 정책과 인증 방식을 함께 봅니다. SMB에서는 디렉터리 서비스 연동, 공유 권한과 파일 권한, 서명·암호화 정책 등이 운영 항목이 됩니다. 같은 공유 폴더를 두 프로토콜로 제공하려면 ID 매핑과 권한 해석까지 지원되는 방식으로 설계해야 합니다.
| 방식 | 제공 단위 | 연결 기반 | 도입 시 확인 항목 |
|---|---|---|---|
| FC의 SCSI 블록 접근 | LUN | FC 패브릭 | HBA·스위치·조닝·다중 경로 |
| iSCSI | LUN | TCP/IP·Ethernet | NIC·IP 경로·호스트 매핑·다중 경로 |
| NVMe/FC·NVMe/TCP | NVMe namespace | FC 또는 TCP/IP | 버전·드라이버·지원 매트릭스 |
| NFS | 파일·디렉터리 | IP 네트워크 | 버전·권한·인증·파일 잠금 |
| SMB | 파일·디렉터리 | IP 네트워크 | 버전·인증·서명·암호화·가용성 기능 |
가상화와 데이터베이스에서는 둘 다 사용할 수 있습니다
VMware: VMFS와 NFS 데이터스토어
VMware 환경에서는 블록 스토리지 위에 VMFS 데이터스토어를 만들거나, NFS 공유를 데이터스토어로 사용할 수 있습니다. VMFS는 여러 ESXi 호스트가 공유하는 가상머신 파일을 관리하는 클러스터 파일시스템입니다. NFS 데이터스토어에서는 파일 서비스가 파일시스템을 관리하므로 NFS 공유를 VMFS로 다시 포맷하는 구조가 아닙니다. ONTAP tools의 NFS·VMFS 데이터스토어 설명
선택할 때는 기존 운영 역량, 지원 프로토콜, 다중 경로와 세션 구성, 백업 연동, 스토리지의 데이터 보호 기능을 비교합니다. ‘VMware이니 SAN만 가능하다’거나 ‘NFS이면 개발용이다’라고 단정할 근거는 없습니다. 다만 가상화 공급사와 스토리지 공급사가 함께 지원하는 조합이어야 합니다.
Hyper-V: SMB 파일 공유도 VM 저장소가 됩니다
Hyper-V는 지원되는 SMB 3 파일 공유에 VM 구성과 VHD·VHDX 등을 저장하는 구성을 사용할 수 있습니다. 따라서 파일 서비스라는 이유만으로 가상화 업무에 부적합하다고 볼 수 없습니다. Microsoft는 Hyper-V와 SQL Server의 SMB 활용을 공식 문서에서 다룹니다. Windows Server SMB와 애플리케이션 스토리지
SMB Multichannel은 여러 연결을 활용하는 기능이고, SMB Direct는 RDMA를 이용하는 기능입니다. SMB를 지원하는 모든 NAS가 이러한 기능과 Hyper-V용 가용성 조건을 모두 충족하는 것은 아닙니다. NAS 제품의 인증, 프로토콜 구현, 클라이언트와 네트워크 장비의 지원을 별도로 확인해야 합니다.
데이터베이스: 연결 방식보다 지원과 일관성이 먼저입니다
데이터베이스를 SAN에 올릴지 NAS에 올릴지는 DB 제품과 버전, 인증된 파일 서비스, 쓰기 일관성, 지연 요구에 따라 결정합니다. 특정 프로토콜의 이름만으로 동기 쓰기 처리나 장애 후 복구를 보장할 수 없습니다. 지원되는 구성에서 로그와 데이터 파일의 I/O 특성을 측정하는 편이 정확합니다.
DB가 쓰기를 완료했다고 응답받는 지점도 중요합니다. 애플리케이션, OS, 프로토콜과 컨트롤러 캐시를 거치는 동안 전원 장애에도 기록이 보존되는 구성이어야 합니다. 성능을 높이려고 안전한 쓰기 동작을 임의로 끄면 데이터 손실 조건이 바뀔 수 있으므로 공급사의 권고와 보호 장치 조건을 따라야 합니다.
SAN이 항상 빠르고 NAS가 항상 느린 것은 아닙니다
성능 비교에는 저장 매체, 컨트롤러, 네트워크, 클라이언트, 접근 패턴과 동시성이 함께 들어갑니다. 올플래시 NAS와 오래된 디스크 기반 SAN을 놓고 결과를 프로토콜 차이로만 설명하면 잘못된 결론이 나와요. 같은 장비에서도 작은 랜덤 쓰기와 큰 순차 읽기는 전혀 다른 부하입니다.
IOPS, 처리량, 지연을 같이 봅니다
IOPS는 초당 처리하는 I/O 횟수이고, 처리량은 초당 전달하는 데이터 양입니다. 지연 시간은 한 요청이 완료될 때까지 걸리는 시간입니다. 셋 중 하나만 높다고 전체 업무가 빨라지는 것은 아닙니다.
계산을 위한 예로, 4 KiB 요청을 초당 100,000회 처리한다면 데이터 양은 약 390.6 MiB/s입니다. 같은 100,000 IOPS라도 요청 크기가 달라지면 처리량은 달라집니다. 이 수치는 단위 관계를 보여 주는 산술 예시이며 특정 장비의 측정 결과가 아닙니다.
| 지표 | 읽을 때의 의미 | 같이 기록할 조건 |
|---|---|---|
| IOPS | 작은 요청을 얼마나 처리하는가 | 블록 크기, 읽기·쓰기 비율, 큐 깊이 |
| 처리량 | 큰 데이터를 얼마나 전달하는가 | 파일 크기, 병렬 수, 네트워크 사용률 |
| 평균 지연 | 전반적인 응답 시간 | 부하 수준과 측정 구간 |
| p95·p99 지연 | 느린 요청이 얼마나 길어지는가 | 백업·재구축·장애 시점의 변화 |
10 Gb/s 링크를 8로 나누면 원시 비트율 기준으로 1.25 GB/s입니다. 이는 프로토콜 오버헤드 등을 제외하지 않은 이론값이며 실제 파일 전송 속도와 같지 않습니다. GB/s와 GiB/s, Gb/s의 단위를 섞지 않고 비교하는 것부터 시작하면 견적서의 성능 수치를 읽기 쉬워집니다.
캐시와 작업 데이터 크기를 맞춥니다
스토리지 캐시에 들어가는 작은 데이터만 반복해서 읽으면 실제 업무보다 좋은 결과가 나올 수 있습니다. 운영 데이터의 작업 집합, 읽기·쓰기 비율, 동기 쓰기와 동시 접속을 반영해야 합니다. 중복 제거와 압축이 잘되는 데이터인지도 결과에 영향을 줄 수 있습니다.
평상시 성능만으로 크기를 정하지 않는 편이 좋습니다. 디스크 재구축, 복제 지연 해소, 백업과 컨트롤러 정비가 겹쳤을 때도 업무 목표를 지키는지 봅니다. 특히 평균 지연이 괜찮아도 일부 요청의 긴 지연이 사용자 오류와 타임아웃으로 이어질 수 있습니다.
이중화는 케이블 두 개로 끝나지 않습니다
SAN: 호스트부터 컨트롤러까지 경로를 분리합니다
SAN의 다중 경로 I/O(MPIO)는 하나의 논리 장치에 이르는 여러 경로를 호스트에서 관리하는 방식입니다. 지원 구성에서는 경로 장애가 발생했을 때 다른 경로로 접근을 이어갑니다. ONTAP의 SCSI SAN 설명에서도 MPIO와 ALUA를 통한 경로 선택·장애 처리를 다룹니다. NVMe 구성은 해당 OS와 공급사의 NVMe 다중 경로 지침을 별도로 확인해야 합니다. 스토리지 경로 장애 처리
HBA 포트가 둘이어도 같은 카드의 장애에 함께 영향을 받을 수 있습니다. 스위치 두 대가 같은 전원 경로에 있거나, 모든 케이블이 같은 단일 컨트롤러에 연결되어도 공통 장애 지점이 남습니다. 호스트 포트, 스위치, 스토리지 포트, 컨트롤러와 전원 경로를 연결해서 그려 보면 빠진 부분이 드러납니다.
Ethernet 링크 집계와 MPIO도 목적과 동작 계층이 다릅니다. 링크를 묶었다고 스토리지 장치의 다중 경로 설정을 대신하지는 않습니다. 대역폭 합산과 장애 전환이 실제 I/O에서 어떻게 동작하는지 지원되는 설계로 검증해야 합니다.
FC 조닝과 LUN 매핑은 서로 다른 접근 제어입니다
FC 조닝은 패브릭에서 통신할 수 있는 포트의 범위를 정합니다. LUN 매핑·마스킹은 스토리지에서 어떤 호스트에 어떤 장치를 제공할지 정합니다. 둘 중 하나만 맞아도 되는 설정으로 생각하면 장치가 보이지 않거나 불필요한 호스트에 노출될 수 있습니다. FC 조닝 개념, SAN 호스트 매핑
인증과 접근 제어를 암호화와도 구분해야 합니다. 예를 들어 iSCSI 인증 설정이 있다고 해서 데이터 전송 전체가 자동으로 암호화된다고 가정하면 안 됩니다. 전송 보호 요구가 있으면 프로토콜과 네트워크의 지원 방식까지 포함해 설계합니다.
NAS: 파일 서비스의 가용성까지 확인합니다
NAS에서는 NIC와 스위치의 이중화에 더해 파일 서비스 장애 조치, 클라이언트의 재연결과 파일 핸들 처리까지 확인합니다. IP가 다시 응답한다고 열려 있던 파일과 애플리케이션 작업이 모두 정상 복구된 것은 아닙니다. NFS·SMB 버전과 제품 기능, 클라이언트 설정에 따라 동작이 달라집니다.
시험은 케이블 단절, 스위치 정비, 컨트롤러 전환처럼 장애 지점을 나누어 수행합니다. 파일을 읽는 중인지, 큰 파일을 쓰는 중인지, DB가 동기 쓰기를 하는 중인지도 결과에 영향을 줍니다. 운영자가 체감하는 복구 시간은 네트워크 복구와 애플리케이션 재시도 시간을 모두 포함합니다.
공유 스토리지라고 모든 서버가 동시에 써도 되는 것은 아닙니다
동일한 블록 장치를 여러 서버에 보이게 하는 일과, 그 장치에 여러 서버가 안전하게 쓰는 일은 다릅니다. 일반적인 단일 호스트용 ext4·XFS 파일시스템을 여러 서버에서 같은 장치에 동시에 읽기·쓰기로 마운트하면 메타데이터가 손상될 수 있습니다. 지원되는 클러스터 파일시스템이나 애플리케이션의 공유 디스크 구조가 필요합니다. Red Hat의 로컬·공유 파일시스템 구분
VMFS 같은 클러스터 파일시스템은 여러 호스트 접근을 고려하지만, 이것이 같은 VM의 가상 디스크를 여러 게스트에서 임의로 동시 수정해도 된다는 의미는 아닙니다. 다중 쓰기 기능과 게스트 클러스터의 지원 조건을 별도로 확인해야 합니다. 저장 계층의 공유와 애플리케이션의 동시성 제어를 나누어 생각합니다.
NAS는 여러 클라이언트의 파일 접근을 처리하지만 애플리케이션의 데이터 충돌까지 자동 해결하지는 않습니다. 파일 잠금 방식과 DB의 동작 조건이 맞아야 합니다. 공유 폴더에서 여러 사용자가 파일을 편집할 수 있다는 사실을 모든 데이터베이스의 다중 쓰기 허용으로 확대하면 안 됩니다.
Kubernetes의 RWO·RWX도 같은 관점으로 읽습니다
Kubernetes에서 블록 스토리지는 단일 노드의 읽기·쓰기에 사용하고 파일 스토리지는 여러 노드의 공유에 사용하는 구성이 흔합니다. 그러나 실제 접근 모드는 CSI 드라이버와 스토리지 기능이 결정하며, ‘SAN이면 무조건 RWO, NAS이면 무조건 RWX’라는 고정 규칙은 아닙니다.
ReadWriteOnce(RWO)는 하나의 노드에서 읽기·쓰기로 마운트하는 모드이며, 그 노드 안의 여러 Pod가 접근할 수 있습니다. ReadWriteMany(RWX)는 여러 노드의 읽기·쓰기를 나타냅니다. 접근 모드 선언만으로 모든 쓰기 충돌을 막는 것은 아니며, 단일 Pod 제한이 필요하면 지원되는 CSI의 ReadWriteOncePod 같은 별도 조건을 봐야 합니다. Kubernetes 영구 볼륨의 접근 모드
표시 용량과 실제로 쓸 수 있는 용량은 다릅니다
디스크의 표기 용량을 합한 raw capacity가 곧 업무에서 쓸 수 있는 공간은 아닙니다. RAID나 복제 정책, 예비 공간, 메타데이터, 스냅샷과 운영 여유를 고려해야 합니다. 제품마다 사용 가능 용량과 효율 적용 용량을 표시하는 기준도 다를 수 있습니다.
단순한 산술 예로 동일한 8 TB 디스크 8개를 RAID 6의 이중 패리티 계산만 적용하면 명목상 48 TB가 됩니다. 이는 핫스페어, 메타데이터, 파일시스템, 단위 차이와 예비 용량을 반영하기 전의 값입니다. 실제 장비의 권장 사용 가능 용량으로 그대로 사용하면 안 됩니다.
Thin provisioning은 여유 공간 감시가 필요합니다
씬 프로비저닝은 논리 공간을 먼저 제공하고 실제 사용에 따라 물리 공간을 할당하는 방식입니다. 초기 낭비를 줄일 수 있지만, 여러 볼륨이 함께 커지면 물리 풀이 먼저 가득 찰 수 있습니다. 호스트에 남은 공간과 스토리지 풀의 남은 공간을 모두 감시해야 합니다. 스토리지 효율과 씬 프로비저닝
스냅샷 보관, 복제 지연, 압축·중복 제거의 효과도 공간 사용을 바꿉니다. ‘논리 용량을 충분히 크게 만들었다’는 사실은 실제 디스크 공간 확보와 다릅니다. 변경량이 큰 업무라면 데이터 증가뿐 아니라 스냅샷이 붙잡고 있는 공간도 함께 계산해야 합니다.
RAID, 스냅샷, 복제와 백업의 역할
RAID는 정해진 범위의 디스크 장애를 견디는 데 쓰입니다. 사용자가 삭제한 파일, 잘못된 DB 수정, 계정 탈취와 사이트 전체 장애를 모두 해결하지는 않습니다. 디스크가 정상이어도 업무 데이터는 손상될 수 있습니다.
스냅샷은 특정 시점의 상태로 빠르게 돌아가는 데 유용합니다. 그러나 같은 스토리지와 같은 관리자 권한에만 의존하면 장비 장애나 침해에 함께 영향을 받을 수 있습니다. 복제도 잘못된 변경을 다른 시스템에 전달할 수 있으므로, 정상 시점의 데이터를 별도로 보관하고 복원하는 체계가 필요합니다.
| 수단 | 주로 보호하는 상황 | 별도로 준비할 부분 |
|---|---|---|
| RAID·분산 복제 | 일부 디스크·노드의 고장 | 삭제·오염·재해 복구 |
| 스냅샷 | 가까운 과거 시점으로 복귀 | 보관 공간, 권한, 장비 밖 복구 경로 |
| 원격 복제 | 다른 시스템·사이트의 사본 유지 | 복제 지연, 정상 시점 보존, 전환 |
| 별도 백업 | 과거 데이터와 시스템 복원 | 무결성 확인, 보관 격리, 복원 시험 |
랜섬웨어 대응에서는 관리 권한 분리와 함께 오프라인 또는 적절히 격리된 사본, 변경·삭제 방지 보관을 검토합니다. CISA도 중요한 데이터의 오프라인·암호화 백업과 정기적인 복원 검증을 권고합니다. 백업 작업의 성공 표시만 보지 말고 필요한 파일과 DB가 정상적으로 열리는지 확인해야 합니다. CISA 랜섬웨어 대응 지침
복구 목표도 미리 정해야 합니다. RPO는 허용 가능한 데이터 손실 시간 범위이고, RTO는 업무 복구까지 허용하는 시간 목표입니다. 예를 들어 ‘최근 15분까지의 변경 손실 허용, 2시간 안에 업무 재개’는 설명을 위한 목표 예시입니다. 실제 목표는 업무 담당자와 정하고 복원 시험으로 달성 여부를 확인합니다.
어떤 업무에 무엇을 선택할까
공유 문서, 부서 파일, 콘텐츠 저장처럼 파일 경로와 사용자 권한이 중심이면 NAS 파일 서비스를 먼저 검토하기 좋습니다. 운영자가 공유, 할당량과 권한을 중앙에서 관리할 수 있기 때문입니다. 작은 파일이 매우 많거나 동시 접근이 크다면 파일 서비스와 메타데이터 처리 능력을 함께 확인해야 합니다.
서버가 블록 장치와 파일시스템을 직접 관리해야 하거나, 기존에 인증된 DB·가상화 SAN 운영을 이어가야 한다면 블록 스토리지가 출발점이 됩니다. 이때 외장 SAN만이 가능한 것은 아닙니다. 하이퍼컨버지드 인프라나 분산 스토리지도 블록 서비스를 제공할 수 있으므로 전체 운영 구조를 비교합니다.
| 업무 조건 | 우선 검토할 구성 | 선택을 바꿀 수 있는 조건 |
|---|---|---|
| 사용자·부서의 파일 공유 | SMB·NFS 파일 서비스 | 인증·권한, 파일 수, 외부 협업 방식 |
| 기존 SAN 기반 가상화 유지 | 지원되는 블록 데이터스토어 | 장비 교체 시기, 백업·라이선스·운영 기술 |
| 가상화 저장소 신규 설계 | 블록과 NFS·지원 SMB 구성 비교 | 플랫폼 인증, 장애 전환, 관리 일관성 |
| DB의 낮은 지연·안정적 쓰기 | 공급사가 지원하는 블록 또는 파일 | DB 버전, 쓰기 보호, 복구·성능 검증 |
| 여러 Kubernetes 노드의 파일 공유 | RWX를 지원하는 파일·CSI 구성 | 잠금, 드라이버, 처리량·접근 제어 |
| 장기 보관·대규모 객체 접근 | 객체 스토리지도 함께 검토 | API·수명 주기·애플리케이션 호환성 |
객체 스토리지는 버킷과 객체 API를 중심으로 접근하는 별도 모델입니다. SAN과 NAS의 중간 단계나 상위 등급을 뜻하지 않습니다. 애플리케이션이 파일시스템을 요구하는데 객체 API만 제공하면 바로 대체할 수 없으므로 연결 방식부터 확인합니다. 객체·버킷 접근의 예: Amazon S3
견적에는 장애 시 성능과 복구 비용을 넣습니다
SAN은 HBA와 스위치, 광 모듈, 지원 계약이 비용에 포함될 수 있고, NAS도 고속 NIC·스위치, 컨트롤러, 인증 연동과 가용성 기능이 필요할 수 있습니다. 기존 장비를 재사용할 수 있는지, 증설할 때 노드·셸프·포트 중 무엇을 추가해야 하는지에 따라 비용이 달라집니다.
견적 비교에는 정상 상태의 사용 가능 용량뿐 아니라 한 구성 요소가 빠졌을 때의 성능, 복구·재보호에 걸리는 시간, 백업 저장 공간과 운영 인력을 함께 넣습니다. 단가가 낮더라도 복원 경로가 없거나 장애 때 목표 지연을 넘으면 필요한 업무 조건을 충족하지 못합니다.
운영 시작 전에 남겨 둘 정보
장치 이름만 기록하면 장애 때 실제 경로를 찾기 어렵습니다. SAN은 호스트 식별자, 장치 식별자, 조닝·매핑과 다중 경로를, NAS는 공유 경로, 인증, 권한과 서비스 장애 조치 구조를 연결해 보관합니다. 담당자가 바뀌어도 데이터를 어떤 경로로 복구하는지 찾을 수 있어야 합니다.
- 애플리케이션, 데이터 위치, 프로토콜과 담당자를 한 문서에 연결합니다.
- 정상 상태의 지연, IOPS, 처리량, 여유 공간과 오류 수를 기준값으로 남깁니다.
- 호스트·스위치·컨트롤러의 장애 경로를 그려 공통 장애 지점을 확인합니다.
- 지원되는 OS·드라이버·펌웨어 조합과 업데이트 순서를 기록합니다.
- 별도 백업에서 데이터를 복원하고 애플리케이션의 읽기·쓰기를 검증합니다.
- 장애 후 원래 경로로 돌아가는 절차와 변경 이력을 관리합니다.
SAN과 NAS 중 하나를 먼저 정하기보다, 업무가 블록 장치를 요구하는지 파일 공유를 요구하는지부터 확인해 보세요. 그 다음 지원 구성, 장애 시 동작과 복원 결과를 맞춰 가면 제품 이름에 휘둘리지 않고 필요한 스토리지를 고를 수 있습니다.
공식 자료와 확인 기준
개념과 제품 문서는 2026년 10월 18일 기준으로 확인했습니다. 계산 예시는 단위와 용량 관계를 설명하기 위한 값이며 실제 장비 벤치마크가 아닙니다. 대표 사진은 2014년에 촬영된 HP EVA4400 장비의 참고 사진으로, 현재 제품의 성능이나 이 글에서 구축한 환경을 나타내지 않습니다.



